
ε-greedy方策は、確率1−εで今いちばん良さそうな選択肢を選び、確率εで全部の選択肢から一様にランダムに選ぶ方法です。読み方はイプシロン・グリーディです。
ここで読み違えやすい点が1つあります。「ε=0.1だから、10回に1回は別の台を冒険している」と思っていませんか? 実際は、ランダムの候補にいつもの台も入っています。スロットが3台なら、別の台を引く確率は0.067で、約15回に1回しかありません。
この記事を読むと、次の3つが手に入ります。
- ε=0.1の「0.1」が実際に何の確率なのかを、3台の計算で説明できる
- 標準ライブラリだけで動くコードで、ε=0・0.1・0.5・1・減衰を同じ条件で動かした数字が見られる
- ε=0.1とUCB1の順位が入れ替わる例を、実測の数字で確かめられる(10台で、1000回と10万回の順位が入れ替わる例を載せています)
「ときどきランダム」という覚え方は、試験の用語としては通じても、εをいくつにするかの判断には届きにくいと思います。
G検定に合格した理学療法士で、職場のDX推進担当のにこいちです。
この記事では、その覚え方を、コードと数字で確かめられる形にします。
ε-greedy方策とは:ふだんは一番、ときどきランダム
ε-greedy方策の選び方は、次の2通りです。
- 確率1−εで、平均(Q値)が最大の選択肢を選ぶ
- 確率εで、全部の選択肢から一様にランダムに選ぶ
εは0から1の間の数で、ランダムに選ぶ確率です。平均(a)は選択肢aのこれまでの平均報酬で、コードでは変数名Qを使います。この記事では、スロットの例では「台」、一般の話では「選択肢」と書きます。
ε-greedy(イプシロン・グリーディ)の動き
1回の選択の流れは、次の3段階です。
0から1の間の値でεを決めます。これがランダムに選ぶ確率です。例はε=0.1です
選ぶたびに、0から1までの一様乱数rを引きます
rがεより小さければ、全部の選択肢から一様にランダムに選びます(探索)。この中には、いつもの選択肢も入っています。rがε以上なら、平均がいちばん高い選択肢を選びます(活用)。同点なら、その中から1つランダムに選びます
次の図は、台を選ぶ1回の流れを表しています。色の付いた右の箱が、この記事でいちばん見てほしい分岐です。
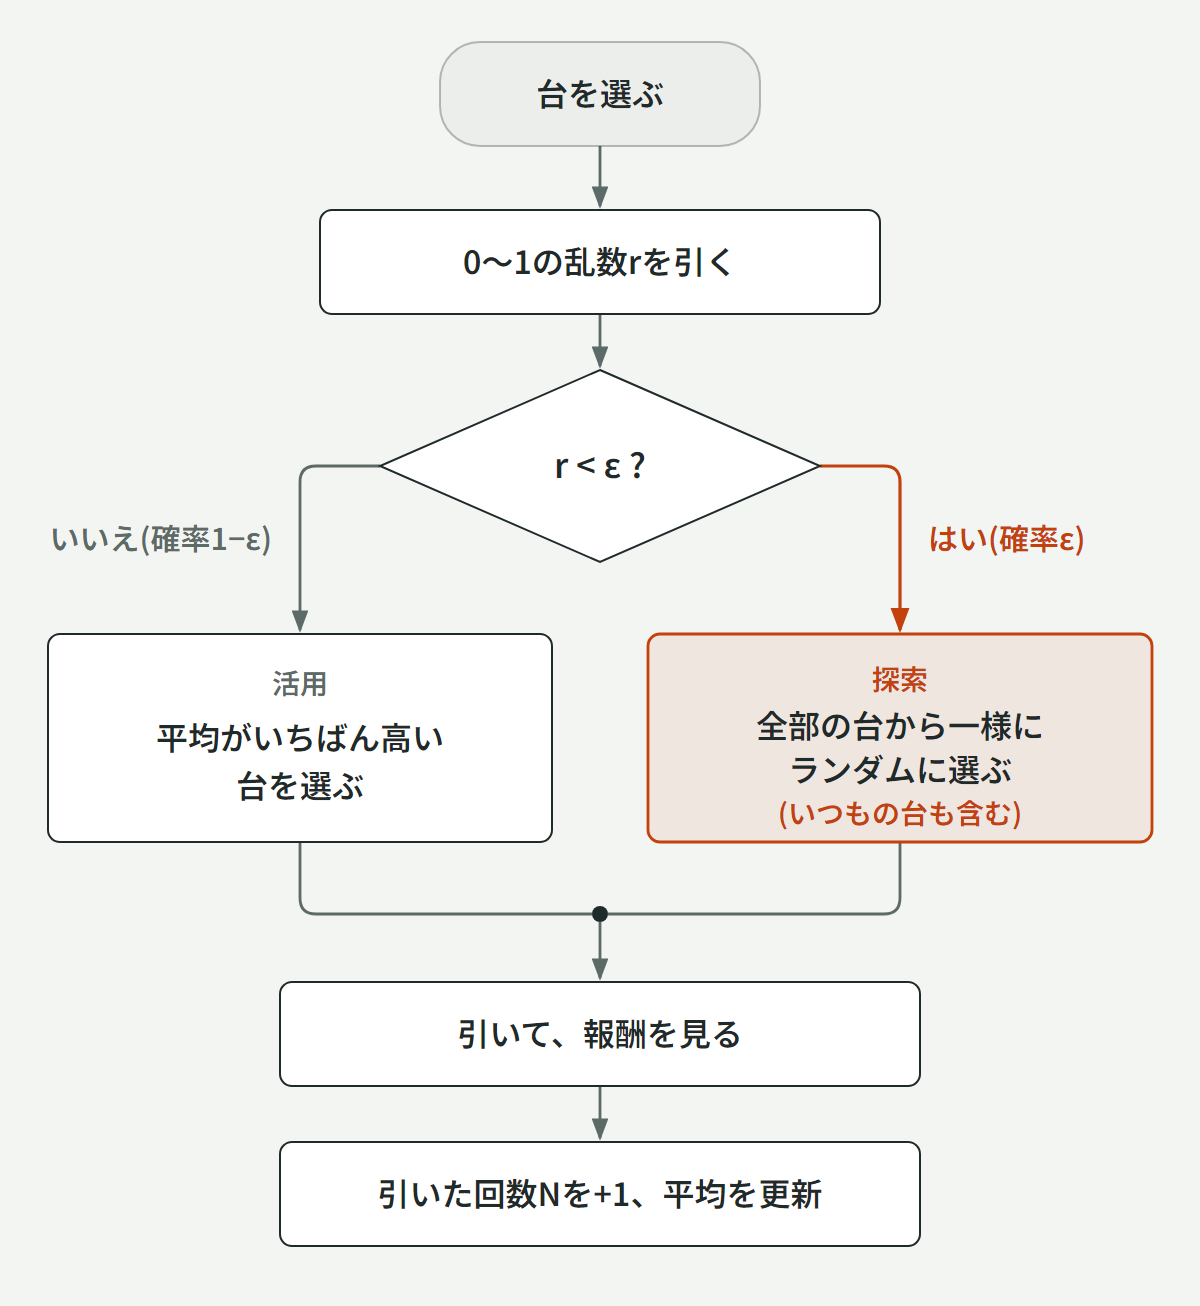
図の「r < ε ?」で「はい」に進んだとき、全部の台から一様に選ぶ箱が、いつもの台も含む分岐です。この枝で0.1×(1/3)が足される様子は、次の節の表で確かめられます。
ランダムの中に、いつもの選択肢も入っている
計算するのは、スロット3台でε=0.1のときの確率です。いつもの台(今の平均がいちばん高い台)は、活用の枝でも、ランダムの枝でも選ばれます。
| 台 | 活用の枝 | ランダムの枝 | 選ばれる確率 |
|---|---|---|---|
| いつもの台 | 0.9 | 0.1×(1/3) | 約0.933 |
| ほかの台(1台あたり) | 0 | 0.1×(1/3) | 約0.033 |
いつもの台を選ぶ確率は、0.9+0.1×(1/3)で約0.933です。ほかの2台はランダムの枝でしか選ばれず、1台あたり約0.033になります。
つまり「別の台を試す確率」は0.1ではなく、2台ぶんの約0.067です。回数にすると約15回に1回です。ε=0.1を「10回に1回は別の台を試す」と読むと、実際より多く見積もることになります。「ときどき別の選択肢を選ぶ」という言い方は、定義より狭くなります。
たとえば、毎週行くラーメン屋が決まっている人が、「10回に1回は別の店」と決めたつもりで、その回の店をくじで選ぶ場合です。くじの候補にいつもの店も入っていたら、別の店に行くのは10回に1回より少なくなります。ε-greedy方策のランダムの枝は、このくじと同じ形です。
探索と活用
探索は、まだあまり試していない台を引いて、当たりやすさの情報を集めることです。活用は、これまでの結果からいちばん当たりやすそうな台を引くことで、利用とも呼ばれます。活用ばかりだと、たまたま最初に当たった台を引き続けて、もっと良い台を見逃すことがあります。探索ばかりだと、良いと分かった台を十分に引けません。ε-greedy方策は、この配分を確率で決める方法です。
ε-greedy方策の利点は、次の3つです。
- 探索と活用の配分を、εの値ひとつで決められる
- εが0より大きければ、時間がたつとどの選択肢も何度でも選ばれる
- 乱数で2通りに分けるだけなので、コードが短い
ε-greedyの定義と、εの例として0.1が挙げられることは、解説記事のWikipediaとLil'Logに沿って書いています。UCB1と、εを小さくしていくεn-GREEDYは、Auer、Cesa-Bianchi、Fischerの論文「Finite-time Analysis of the Multiarmed Bandit Problem」(Machine Learning 47巻、2002年)で示された方法です。この論文は本文を確認しています。Sutton & Bartoの教科書の本文は確認できていません。
動くPythonコードで、スロット3台を引いてみる
私はPythonでデータ分析の連載を書きました。
Pythonを読むのが苦手な方も、読むのは3か所だけです。ここでは、標準ライブラリだけで動くコードを載せます。
台は3台で、当たり確率は0.2、0.8、0.5です。当たりは1点、はずれは0点とします。確率の違う台が並ぶこの形の問題を、多腕バンディット問題と呼びます。
コード
import random


def epsilon_greedy(K, epsilon_at, play_arm, max_steps, rng):
    """ε-greedyで多腕バンディット問題を解く。報酬は0か1を前提とする。
    epsilon_at(t) は、これまでに引いた回数 t のときのεを返す関数。"""
    N = [0] * K      # 各台を引いた回数
    Q = [0.0] * K    # 各台の平均報酬
    total_reward = 0
    selected = []

    # 初期化: 全部の台を1回ずつ引く(UCB1のコードとそろえた)
    for a in range(K):
        r = play_arm(a)
        N[a] = 1
        Q[a] = r
        total_reward += r
        selected.append(a)

    # メインループ: t はこれまでに引いた回数の合計
    for t in range(K, max_steps):
        if rng.random() < epsilon_at(t):
            a = rng.randrange(K)    # 探索: 全部の台から一様に選ぶ(いつもの台も含む)
        else:
            best = max(Q)           # 活用: 平均がいちばん高い台。同点ならその中から選ぶ
            a = rng.choice([i for i in range(K) if Q[i] == best])
        r = play_arm(a)
        total_reward += r
        selected.append(a)
        N[a] += 1
        Q[a] += (r - Q[a]) / N[a]   # 平均の増分更新(N は更新後の回数)

    return total_reward, selected


if __name__ == "__main__":
    p = [0.2, 0.8, 0.5]   # 台ごとの当たり確率(本当は知らない)
    rng = random.Random(0)
    play = lambda a: 1 if rng.random() < p[a] else 0
    total, arms = epsilon_greedy(len(p), lambda t: 0.1, play, 100, rng)
    print("合計:", total)
    print("各台を引いた回数:", [arms.count(a) for a in range(len(p))])
コードの読み方
読むところは、初期化、選ぶ、更新の3か所です。
初期化は、最初のforループです。3台を順に1回ずつ引き、N[a]を1に、Q[a]をその報酬にします。全部の台を1回ずつ引くのはUCB1のコードとそろえるためで、ε-greedyの定義に必須の手順ではありません。全部の平均を0から始めると、ε=0では最初に当たった台の平均だけが0より大きくなり、その台を引き続けます。あとでUCB1と並べるときに条件がそろうよう、この形にしました。
選ぶところは、次のforループの先頭です。tはこれまでに引いた回数の合計で、3から始まります。rng.random() < epsilon_at(t)が、乱数rとεの比較です。rが小さいときのrng.randrange(K)は全部の台から一様に選ぶ処理で、いつもの台も対象です。そうでなければ、平均がいちばん高い台を選びます。同点の台があるときに、その中から1つ選ぶのがrng.choiceです。
εを関数epsilon_atで渡しているのは、固定のεと、少しずつ小さくするεを、同じコードで比べるためです。固定で0.1にするときはlambda t: 0.1を渡します。
更新は、ループの最後の2行です。N[a] += 1で回数を先に増やし、そのあとに新しい回数で割って平均を直します。
新しい平均は「古い平均 + (報酬 − 古い平均) ÷ 更新後の回数」です。例として、平均0.50で4回引いた台が5回目に当たると、0.50 + (1 − 0.50) ÷ 5で0.60になります。当たりの合計3を回数5で割った値と同じです。すべての報酬を覚えておかなくても、この1行で平均を更新できます。
報酬を出すのはplayの行です。当たり確率p[a]で1を、それ以外で0を返します。当たり確率p[a]を見ているのはplayだけで、epsilon_greedyの中では見ていません。選ぶ側は、引いた結果だけで台を決めます。
100回引いた結果
コードを実行すると、次のように出ます。乱数のseedを0に固定しているので、同じ版のPythonなら何度実行しても同じ数字です。
合計: 78
各台を引いた回数: [4, 91, 5]
台ごとの報酬も集計すると、次の表になります。推定した平均はコードの表示には出ないので、引いた結果を台ごとに集計して出した値です。
| 当たり確率 | 引いた回数 | 推定した平均 |
|---|---|---|
| 0.2 | 4 | 0.00 |
| 0.8 | 91 | 0.81 |
| 0.5 | 5 | 0.80 |
引いた回数の合計は100で、当たりの合計は78になります。
91回引いた当たり確率0.8の台は、推定した平均が0.81で、本当の確率に近い値です。一方で、当たり確率0.5の台は5回しか引いておらず、推定した平均は0.80でした。当たり確率0.2の台は4回ともはずれて0.00です。この1回の実行では、引いた回数の少ない2台の推定が、本当の確率からこれだけずれました。
εの決め方:0・0.1・0.5・1で比べる、そして減衰
εを変えて、1000回×200通りで動かした結果
同じ3台を1000回引く実行を、seedを0から199まで変えて200通り動かすと、次の結果が出ます。最良の台は、当たり確率0.8の台です。減衰は、εを少しずつ小さくする方法です(あとの節で説明します)。
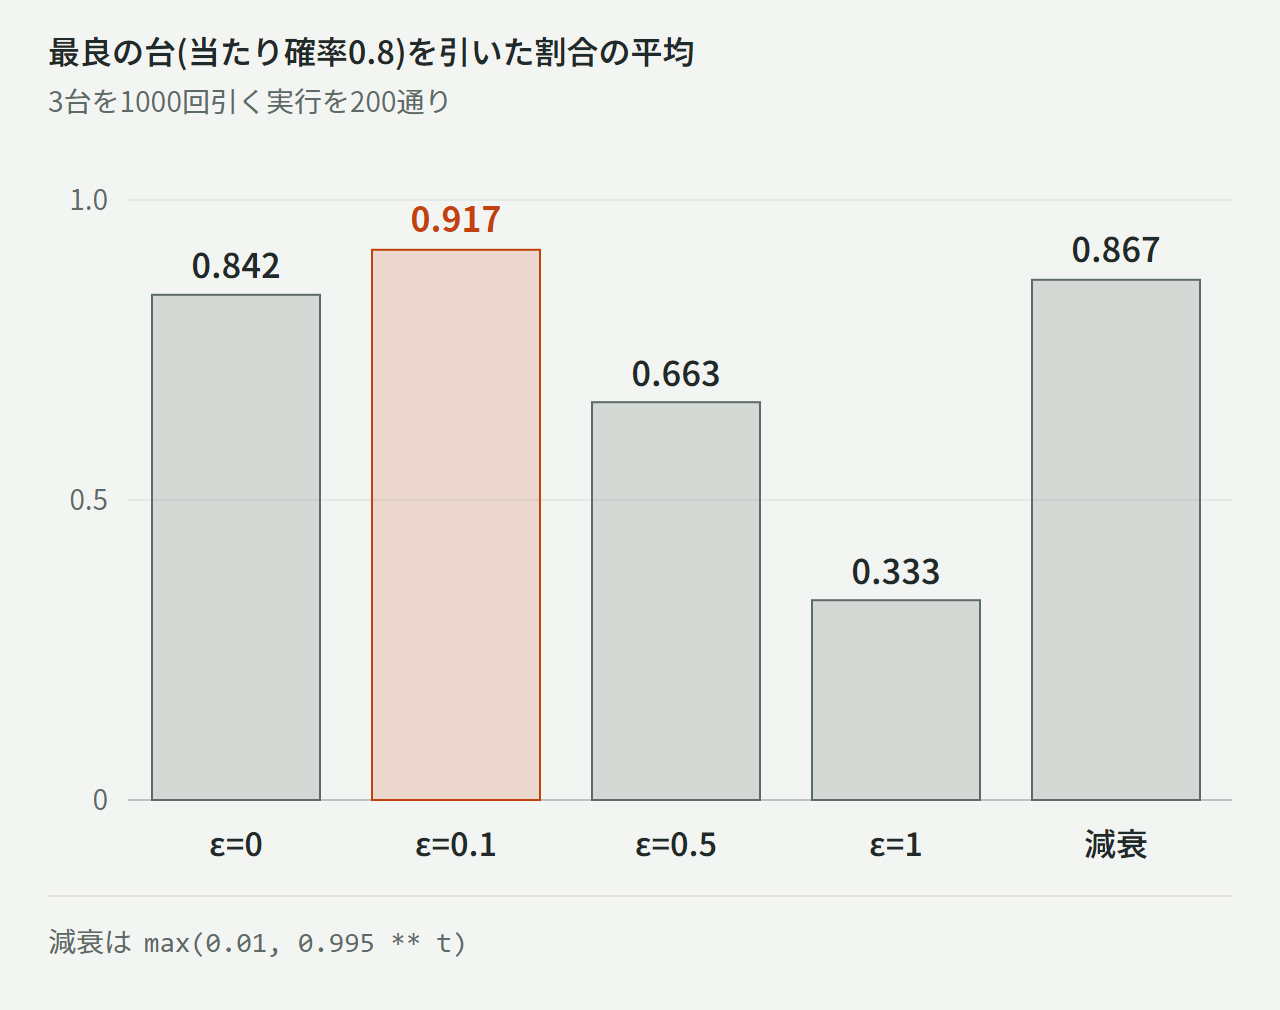
| 条件 | 最良の台を引いた割合の平均 | 当たり回数の平均 | 最良の台が最も多く引かれたseedの数 |
|---|---|---|---|
| ε=0 | 0.842 | 744.6 | 169/200 |
| ε=0.1 | 0.917 | 764.2 | 200/200 |
| ε=0.5 | 0.663 | 647.5 | 200/200 |
| ε=1 | 0.333 | 498.6 | 69/200 |
| 減衰 | 0.867 | 739.0 | 200/200 |
200通りを回す部分は本文のコードに載せていません。Random(0)の0をseedの番号に、引く回数の100を1000に、lambda t: 0.1を比べるεに変えると、同じ条件で動きます。
読み取れること
ε=0は、最初の数回の結果に引きずられます。最良の台が最も多く引かれたのは169通りで、最良の台を引いた回数が100回未満だった実行が31通りありました。最良の台の最初の1回がはずれて別の台が当たると、最良の台の平均は0のままなので、ε=0ではもう選ばれません。
ε=1は毎回ランダムです。各台が引かれた割合は0.334、0.333、0.334で、約3分の1ずつになります。平均を見ずに選ぶので、最も多く引かれる台も偶然で決まり、最良の台が最多だったのは69通りでした。
ε=0.5は、200通りすべてで最良の台が最も多く引かれました。それでも、最良の台を引いた割合は0.663です。どの台が良いかが見えてきたあとも半分の回をランダムに使うので、当たり回数も647.5にとどまります。
ε=0.1は、最良の台を引いた割合が0.917で、当たり回数が764.2です。1回ごとに最良の台を選ぶ確率は、最初の計算のとおり0.933を超えません。探索を続けるので1回ごとの確率はこの上限までで、200通りの平均の0.917もこの値より低く出ました。
5つの中で割合も当たり回数もいちばん高いのは、この条件ではε=0.1でした。ただし、台の確率の差や引く回数が変われば、順番も変わることがあります。この表で言えるのは、ε=0では良い台を見逃す実行が出て、ε=0.5とε=1ではランダムに使う回のぶんだけ当たりが減るということです。
決め方としては、例によく挙がる0.1から動かし始めて、自分の問題の条件で値を変えて比べる順番になります。このコードなら、変えるのはlambda t: 0.1の1か所です。
ε減衰:式ごとに違いを見せる
ε減衰は、εを少しずつ小さくする方法です。表の減衰は、max(0.01, 0.995 ** t)でεを決めました。tはこれまでに引いた回数の合計です。εは1に近い値から下がっていき、0.01より下にはなりません。この式はやり方の一例で、おすすめの値ではありません。
結果は、最良の台を引いた割合が0.867で、当たり回数が739.0です。この条件では、ε=0.1の0.917と764.2より低い結果です。この式だと、しばらくはεが0.1より大きい値のままなので、早い時期にランダムを多く使います。
ε=0と比べると、割合は0.842より高く、当たり回数は744.6より少なくなっています。最良の台が最も多く引かれたのは200通りすべてで、ε=0の169通りを上回りました。
この式は指数減衰と呼ばれる形です。減衰の式はほかにもあり、反比例のmin(1, c/t)と並べると、εの下がり方の違いが数字で見えます。反比例の式では、tがcに届くまでεは1のままです。
| 引いた回数t | 指数減衰 max(0.01, 0.995^t) | 反比例 c=10 | 反比例 c=100 |
|---|---|---|---|
| 10 | 0.951 | 1 | 1 |
| 100 | 0.606 | 0.1 | 1 |
| 300 | 0.222 | 0.033 | 0.333 |
| 500 | 0.082 | 0.02 | 0.2 |
| 1000 | 0.01 | 0.01 | 0.1 |
指数減衰は、100回目でもεが0.606で、半分以上の回をランダムに使います。0.1を下回るのは500回目の手前で、探索の期間が長い式でした。反比例のc=10は100回目で0.1まで下がり、c=100は1000回目でようやく0.1です。
では、後悔で比べるとどうなるでしょうか。後悔は、最良の台を毎回引いた場合との差の累積です。ここでは1回ごとに、最良の台と選んだ台の当たり確率の差を足しています。小さいほど、最良の台に近い選び方だったことになります。
次の表は、別に動かした実験です。同じ3台(0.2/0.8/0.5)をnumpyの乱数で動かしました。1つの乱数生成器で、200本の試行を同時に動かした平均です。同点はランダムに選びます。上の表はPythonのrandomで動かしたので、数字は完全には一致しません。
| 条件(後悔 / 最良の台の割合) | 1000回 | 1万回 | 10万回 |
|---|---|---|---|
| ε=0.1 | 36.6 / 0.914 | 307.1 / 0.931 | 3006.3 / 0.933 |
| ε=0.01 | 44.3 / 0.872 | 92.7 / 0.974 | 362.7 / 0.991 |
| 指数減衰 max(0.01, 0.995^t) | 59.5 / 0.867 | 86.3 / 0.981 | 356.3 / 0.992 |
| 反比例 min(1, 10/t) | 19.1 / 0.955 | 27.1 / 0.994 | 34.0 / 0.999 |
| 反比例 min(1, 100/t) | 98.9 / 0.780 | 168.1 / 0.963 | 237.6 / 0.995 |
| UCB1 | 39.0 / 0.896 | 74.1 / 0.980 | 105.7 / 0.997 |
固定のε=0.1は、10万回引いても最良の台の割合が0.933です。最初に計算した確率と同じ値です。探索を続けるので、1回ごとの確率はこの値を超えません。
この3台では、反比例のc=10がどの回数でも後悔がいちばん小さく、1000回で19.1、10万回で34.0です。同じ反比例でも、c=100は1000回の98.9が6つの中でいちばん大きい値です。同じ形の式でも、cの値で順位が変わります。
c=10の式は、台の組を変えると順位も変わります。次の節で使う10台(最良が0.8、残りが0.2〜0.7)では、10万回の後悔が1809.4です。同じ条件の指数減衰の528.9や、固定のε=0.01の958.7より大きくなりました。固定のε=0.1の3398.9よりは小さい値です。同じ10台でも、c=100なら421.9で、6つの中でいちばん小さくなります。
僅差の3台(0.8/0.79/0.2)では、c=10の10万回の後悔は452.9です。これは指数減衰の512.7や、ε=0.01の538.7より小さい値です。ただし、最良の台を引いた割合は0.567で、指数減衰の0.721やε=0.01の0.660より低く出ました。0.79の台を引いても後悔は1回につき0.01しか増えないので、割合が低くても後悔は小さく出ます。
つまり減衰の式は、台の組によっては、固定のεより悪くなる場合があります。10台のc=10とε=0.01の差が、その一例です。
理論の面では、Auerらの2002年の論文が、固定のεについて「the constant exploration probability ε causes a linear (rather than logarithmic) growth in the regret」と書いています。εを固定すると、後悔は回数に比例して増えるという意味です。一方で、εを1/nの率で小さくするεn-GREEDYでは、後悔の対数の上限を証明しています(Theorem 3)。この記事の10/tと100/tは実験用に置いた例で、定理の条件に合うかは確かめていません。
同じ論文の実験の節には、「An optimally tuned εn-GREEDY performs almost always best.」とあります。最適に調整したεn-GREEDYが、ほとんどの場合でいちばん良かったという内容です。同じ節には、調整が悪いと性能が急速に落ちる趣旨も書かれています。UCBが常に勝つとは書いていません。
迷路(Q学習)では
スロットの台や、いつもの店を選ぶような話は、1回で終わる選択です。迷路は、選択がつながる問題です。
迷路では、エージェントがスタートからゴールまで移動します。各マス(状態)で上下左右のどれかに動き、状態ごとにQ値を持ちます。Q値は、そのマスでその動きを選ぶと、この先ぜんぶ合わせて何点くらいもらえそうかを表す数です。ε-greedy方策は、状態ごとにこのQ値を見て行動を選びます。
ε減衰を使う場合は、学習の初めはεが高く、ランダムに動く回が多くなります。壁にぶつかりながら、ゴールにつながる道や袋小路の情報を集める段階です。εが下がるにつれて、Q値が高い動きを選ぶ回が増えていきます。Q値については、こちらの記事で解説しています。
UCB方策との違い:同じ条件で動かして並べる
考え方の違い
UCB方策は、選択肢ごとに「平均+ボーナス」を計算し、点がいちばん高いものを選ぶ方法です。足す分を探索ボーナスと呼び、選んだ回数が少ないほど大きくなります。UCB1という名前の方法は、2002年にAuerらが示しました。
| 項目 | ε-greedy | UCB方策 |
|---|---|---|
| 探索の仕方 | 確率εで全部の選択肢からランダムに選ぶ | 回数が少ない選択肢ほどボーナスを足して選ぶ |
| 活用の仕方 | 確率1−εで平均が最大のものを選ぶ | 平均+ボーナスが最大のものを選ぶ |
| 探索に使う情報 | ランダムに選ぶときは過去の結果を使わない | 選択肢ごとの回数と全体の回数 |
| 決める値 | ε(0.1がよく挙げられる) | c(UCB1ではc=√2) |
| 実装 | 乱数で2通りに分けて書く | 回数の記録とボーナスの計算を書く |
いちばん大きな違いは、探索の先の決め方です。ε-greedyのランダムな探索では、十分に試した選択肢や、良くないと分かってきた選択肢も引きます。UCB方策の探索は、回数の少ない選択肢が優先です。
UCBの式と数値例、信頼区間の上限の説明は、次の記事で解説しています。
同じ条件で動かした結果
同じ3台、1000回、seed 0〜199で、ε=0.1とUCB1(c=√2)を動かすと、次のように出ます。この条件での平均です。
| 条件 | 最良の台を引いた割合の平均 | 当たり回数の平均 | 最良の台が最も多く引かれたseedの数 |
|---|---|---|---|
| ε=0.1 | 0.917 | 764.2 | 200/200 |
| UCB1(c=√2) | 0.893 | 759.2 | 200/200 |
割合は0.917と0.893、当たり回数は764.2と759.2で、どちらもε=0.1のほうが少し高い値です。最良の台が最も多く引かれたseedの数は、どちらも200通りすべてでした。
この2行から、どちらが一般に良いかは決められません。ε-greedyの数字はεで大きく変わり、同じ3台でもε=0.5なら当たり回数は647.5でした。別の問題でどちらが良いかは、この結果からは分かりません。
UCB1とε=0.1は、条件で順位が逆転する
UCB1は、後悔の上限が回数の対数で増えるとAuerらが示した方法です(Theorem 1)。固定のε=0.1は、前の節のとおり回数に比例して増えます。それでも、短い回数ではε=0.1と並ぶことも、ε=0.1のほうが後悔が小さいこともあります。
次の表は、台の組と回数を変えて、後悔の累積を並べたものです。左がε=0.1、右がUCB1で、小さいほうが良い値です。
| 台の組(ε=0.1 / UCB1) | 1000回 | 1万回 | 10万回 |
|---|---|---|---|
| 記事の3台(0.2/0.8/0.5) | 36.6 / 39.0 | 307.1 / 74.1 | 3006.3 / 105.7 |
| 僅差の3台(0.8/0.79/0.2) | 25.7 / 19.1 | 236.1 / 68.5 | 2148.5 / 327.4 |
| 10台(0.8と0.2〜0.7) | 64.4 / 150.8 | 384.7 / 398.3 | 3398.9 / 641.0 |
この表もnumpyの乱数で別に動かした実験で、どのマスも1つの乱数生成器で200本の試行を同時に動かした平均を出しました。同点はランダムに選びます。Pythonのrandomで動かした上の表とは乱数が違うので、数字は完全には一致しません。本文のコードでε=0.1を同じ台の組の1000回と1万回で動かして突き合わせると、10台の1000回は後悔61.8で、この表の64.4に近い値でした。
記事の3台は、1000回では36.6と39.0でほぼ並びます。差がわずかなので、この数字だけでは理由は言えません。1万回では307.1と74.1、10万回では3006.3と105.7です。固定のε=0.1の後悔はほぼ回数に比例して増え、UCB1は緩やかに増えます。
10台の1000回は、ε=0.1の64.4がUCB1の150.8の半分未満です。最良の台を引いた割合も、ε=0.1の0.700に対してUCB1は0.429でした。探索ボーナスが過剰な探索のコストとして働く、という説明と合う数字です。ただ、理由をこの実験で確かめたわけではありません。1万回では384.7と398.3でほぼ並び、10万回では3398.9と641.0で順位が入れ替わります。
僅差の3台は、1000回では25.7と19.1で、UCB1のほうが少し小さい値です。10万回では2148.5と327.4で、僅差でも長い回数ではUCB1との差が大きくなります。
同じ表でも、1000回の向きは組によって逆です。この3組では、回数と台の組によって順位が入れ替わりました。この3組から「ε=0.1のほうが強い」とも「UCB1のほうが強い」とも言えません。
ソフトマックスなど
ソフトマックス方策は、Q値に応じた確率で行動を選びます。Q値が高い行動ほど選ばれやすく、Q値が低い行動も選ばれる確率はゼロではありません。ε-greedyのランダムな探索では、どの選択肢も同じ確率で選ばれるので、ここが違います。
確認問題と、次に学ぶこと
確認問題
問1です。多腕バンディット問題でε-greedy方策を使います。ε=0.3のとき、次の1回で活用の枝に入る確率は何%ですか。
(A) 0.3% (B) 3% (C) 30% (D) 70%
タップして正解を表示
答えは(D)の70%です。活用の枝に入る確率は1−εなので、1−0.3で0.7になります。
問2です。台が3台で、ε=0.3とします。現在の平均が最大の台は1台です。この台を選ぶ確率は何%ですか。
(A) 70% (B) 80% (C) 90% (D) 30%
タップして正解を表示
答えは(B)の80%です。活用の枝の0.7に、ランダムの枝でこの台が選ばれる0.3×(1/3)=0.1を足します。問1の70%は活用の枝だけの数字で、ランダムの中にいつもの台も入っているぶん、問2の答えは大きくなります。
問3です。ε=0.1を固定のままにすると、後悔は回数に対してどう増えますか。
(A) 回数の対数で増える (B) 回数にほぼ比例して増える (C) 変わらない
タップして正解を表示
答えは(B)です。Auerらの論文は、εを固定すると、後悔が対数ではなく線形に、つまり回数に比例して増えると書いています。この記事の3台のε=0.1でも、1万回の307.1が10万回で3006.3になりました。
まとめと次の一歩
要点は次の4つです。
- ランダムの中にいつもの選択肢も入るので、スロット3台でε=0.1なら、いつもの台を選ぶ確率は約0.933で、別の台を引く確率は約0.067(約15回に1回)です。
- この記事の3台と1000回の条件では、最良の台を引いた割合はε=0が0.842、ε=0.1が0.917、ε=0.5が0.663、ε=1が0.333でした。
- 減衰の式は、同じ形でも値と台の組で順位が変わります。反比例のc=10は、記事の3台の10万回で後悔34.0、10台の10万回で1809.4でした。
- ε=0.1とUCB1の順位は、この3組では回数と台の組によって入れ替わりました。10台の1000回はε=0.1が小さく、10万回はUCB1が小さい値でした。
コードのpやεを変えて動かすと、各台を引く回数がどう変わるかを見られます。UCBの式と数値例は下の1つ目の記事で、迷路のような問題で出てくるQ値は下の2つ目の記事で解説しています。
この記事とあわせて読まれている記事です。

コメント