
UCB方策は、選択肢ごとに「これまでの平均点+ボーナス」を計算し、点がいちばん高いものを選ぶ方法です。ボーナスは、選んだ回数が少ないほど大きくなります。強化学習の勉強でよく出てくる言葉ですが、式だけを見ても、なぜ回数が少ないと得になるのかは読み取りにくいと思います。
G検定に合格した理学療法士で、職場のDX推進担当のにこいちです。
この記事では、スロット3台の数字で点を実際に計算し、信頼区間とln tの意味、ε-greedyとの違いを整理します。後半に確認問題が2問あり、Pythonで確かめたい人向けの補足をいちばん後ろに付けました。
この記事で整理した3点です。出題の予想ではありません。
- UCB方策の考え方: 試した回数が少なく不確かな選択肢ほど、良い可能性を高めに見積もります。「不確かさに対する楽観主義」と呼ばれます。
- ボーナスの仕組み: 回数が少ないほどボーナスが大きく、「平均+ボーナス」の合計で選びます。
- ε-greedyとの違い: ε-greedyは確率εで一様にランダムに選びます。UCBは、平均にボーナスを足した上側の値で選びます。
G検定のシラバス(第1.4版)には、ε-greedy方策・UCB方策・バンディットアルゴリズムの語があります。
探索と活用のジレンマ:多腕バンディットとは
スロット3台の前で迷う問題
レストランを選ぶときに、いつもの店に行くか、入ったことのない店を試すかで迷うことがあります。いつもの店なら、大きくはずれることは少なそうです。ただ、もっとおいしい店を知らないままになるかもしれません。
同じ迷いを、スロットマシンで考えます。目の前に3台のスロットが並んでいます。台ごとに当たる確率は違いますが、その確率は分かりません。引ける回数は限られていて、目的は当たりの合計をできるだけ増やすことです。この問題設定を、多腕バンディット問題と呼びます。
このとき、選択肢1つ1つを「アーム」と呼びます。アームはスロットの腕から来た呼び名で、スロットマシンの別名ではありません。この記事では、スロットの例では「台」、一般の話では「選択肢」と書きます。
探索と活用
当たりの合計を増やすには、2つの動きが必要です。
探索は、まだあまり試していない台を引いて、当たりやすさの情報を集めることです。活用は、これまでの結果からいちばん当たりやすそうな台を引くことで、利用とも呼ばれます。どちらか一方だけでは、次のようにうまくいきません。
探索ばかりだと、情報を集めることに回数を使いすぎて、良いと分かった台を十分に引けず、当たりの合計が伸びにくくなります。活用ばかりだと、たまたま最初に当たった台を引き続けて、もっと良い台を見逃すことがあります。
探索と活用のどちらに回数を使うかを引くたびに決める問題が、「探索と活用のジレンマ」です。UCB方策は、この配分を足し算で決める方法の1つです。
UCB1は、Auer、Cesa-Bianchi、Fischerの論文「Finite-time Analysis of the Multiarmed Bandit Problem」(Machine Learning 47巻、2002年)で示された方法です。ボーナスと信頼区間の関係、後悔の上限、εを固定したときの後悔は、この論文の本文によります。式の形とε-greedyの定義は、解説記事のLil'LogとWikipediaに沿って書いています。
UCB方策の考え方:選ぶ点数は『平均点+ボーナス』
ボーナスは「選んだ回数が少ないほど大きい」足し算
UCBはUpper Confidence Boundの略です。考え方の元にあるのは「不確かさに対する楽観主義」で、英語ではOptimism in the Face of Uncertaintyと呼ばれます。まだあまり試していない台は情報が足りず、今の平均より良い可能性が残っています。その可能性のぶんを点数に上乗せするのが、楽観的な見積もりです。
点数は2つの部分でできています。これまでの平均点が活用の部分で、ボーナスが探索の部分です。この合計を「UCB値」と呼び、この記事では「UCBの点」とも書きます。
ボーナスについては、誤解しやすいところが3つあります。
- ボーナスは、新しい台だけに付くものではありません。何度か選んだ台にも、小さいボーナスが残ります。
- 全体の回数tが増えると、選んでいない台のボーナスは少しずつ大きくなります。ln tが増えるためです。
- ボーナスは、選ぶときの点数に足すだけです。本当の平均は変わりません。
平均が低い台でも、選ばれないまま回数が進めば順番が回ってくることがあるのは、2番目の性質があるためです。1回引けばその台の回数が増えて、ボーナスは小さくなります。
信頼区間の上側で比べるから「UCB」
何回か引いて出した平均は、本当の平均と同じとは限りません。本当の平均が入ると見込む範囲を考えると、引いた回数が少ない台ほど不確かなので、その範囲は広くなります。回数が増えると、範囲は狭くなります。この範囲が信頼区間です。
ボーナスの大きさは、この範囲の片側の幅に関係します。UCB1の論文の説明も、「片側の信頼区間の大きさ」に関係するという内容です。そのため「平均+ボーナス」は、範囲の上側の値にあたります。上側の値どうしで比べるので、Upper Confidence Boundと呼びます。
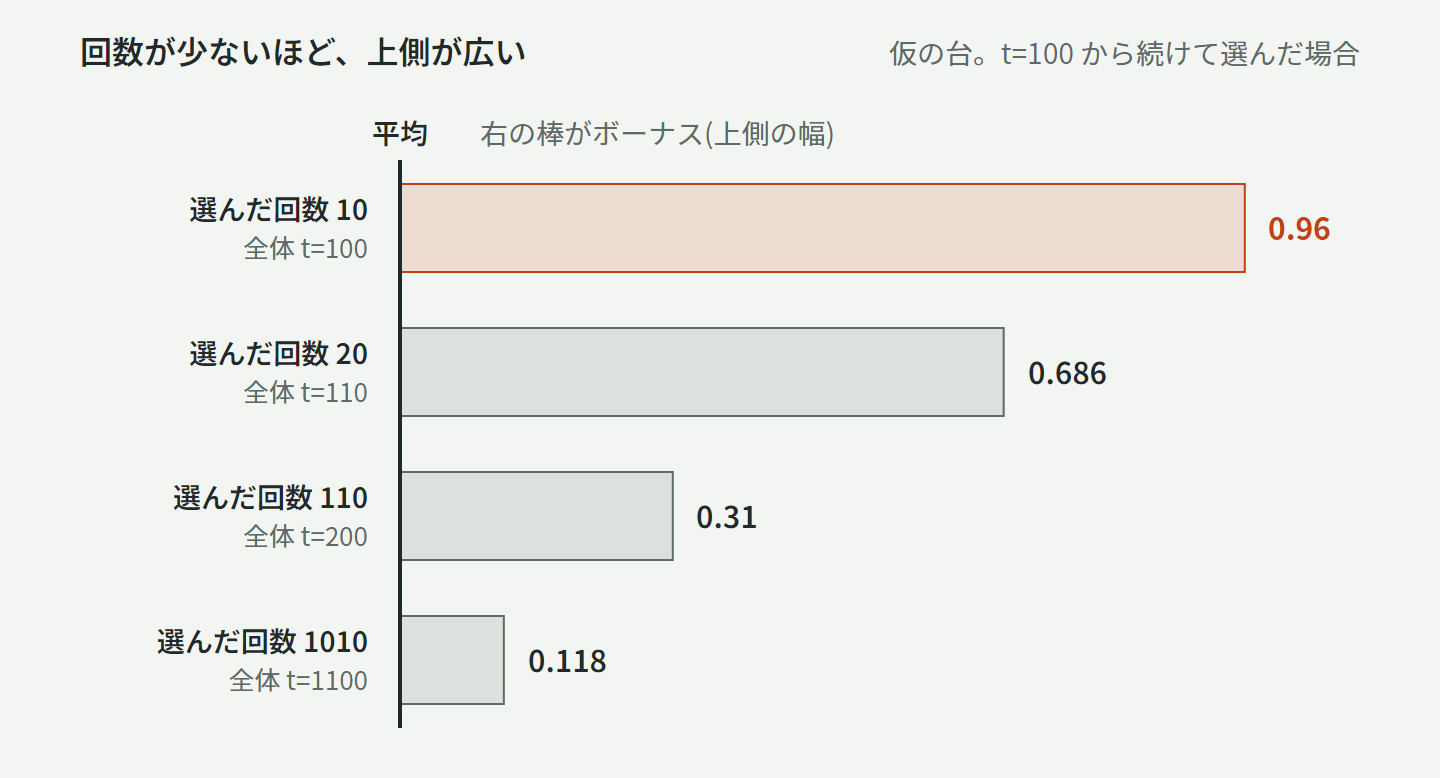
図の数字は仮の台のものです。全体の回数t=100で10回選んだ台を、そのまま続けて選んだときのボーナスです。平均の位置は同じにそろえて、上側の幅だけを比べています。
式:UCB(a) = 平均(a) + c × √(ln t ÷ N(a))、c=√2
UCB方策の式は、次のとおりです。
UCB(a) = 平均(a) + c × √( ln t ÷ N(a) )
右側の「c × √( ln t ÷ N(a) )」がボーナスです。記号の意味は次のとおりです。
- 平均(a): 選択肢aのこれまでの平均報酬です。スロットなら、当たりを1点、はずれを0点として平均します。
- N(a): 選択肢aを選んだ回数です。
- t: これまでに引いた回数の合計です。全部の選択肢のN(a)を足した数と同じです。
- ln t: tの自然対数です。tが増えると、ゆっくり増えます。
- c: 探索の度合いを決める正の定数です。大きいほど、ボーナスの影響が大きくなります。
UCB1では、c=√2(約1.41)を使います。このとき、式は「平均(a) + √( 2 ln t ÷ N(a) )」と同じです。
N(a)は分母にあるので、選んだ回数が少ないほどボーナスは大きくなります。これが、回数が少ない選択肢ほど選ばれやすくなる理由です。
なぜln tなのか
式にはただのtではなく、ln tが入っています。tのままだと何が変わるのかを、数字で比べます。まず、5回選んだあと選ばれないままの台のボーナスです(c=√2)。
| 全体の回数t | ln tを使う √(2 ln t ÷ 5) | tを使う √(2t ÷ 5) |
|---|---|---|
| 10 | 0.96 | 2.0 |
| 100 | 1.36 | 6.32 |
| 1000 | 1.66 | 20.0 |
| 10000 | 1.92 | 63.25 |
| 100000 | 2.15 | 200.0 |
選ばれない台のボーナスは、どちらの式でも全体の回数が増えるにつれて大きくなります。違うのは増え方で、100回から10万回まで進むと、ln tを使うボーナスは1.36から2.15までですが、tを使うボーナスは6.32から200.0まで跳ね上がります。ln tは、ボーナスの増え方にかけるブレーキのようなものです。
この違いは、選び方にも出ます。当たり確率0.1〜0.5の5台を1000回引く場合で、乱数の種(seed)を200通り変えたときの、当たりの合計と台ごとに引いた回数の平均が次の表です。
| 式 | 当たりの合計 | 確率0.1の台 | 確率0.2の台 | 確率0.3の台 | 確率0.4の台 | 確率0.5の台 |
|---|---|---|---|---|---|---|
| ln t | 419.0 | 45.7 | 67.9 | 110.0 | 213.2 | 563.1 |
| t | 312.8 | 175.9 | 186.7 | 199.0 | 212.1 | 226.3 |
tだと、どの台のボーナスも大きくなりすぎて、1000回でどの台も約176〜226回ずつ引かれ、当たりは312.8回でした。ln tだと、当たり確率0.5の台に563.1回が集まり、当たりは419.0回でした。この結果は、この5台・1000回の条件でのものです。
数値例:スロット3台で、どの台が選ばれるか
仮の数字です。実在のデータではありません。
当たりを1点、はずれを0点とします。台Aを10回、台Bを6回、台Cを4回引いたところなので、全体の回数はt=20です。ここで、次にどの台を引くかを計算します。
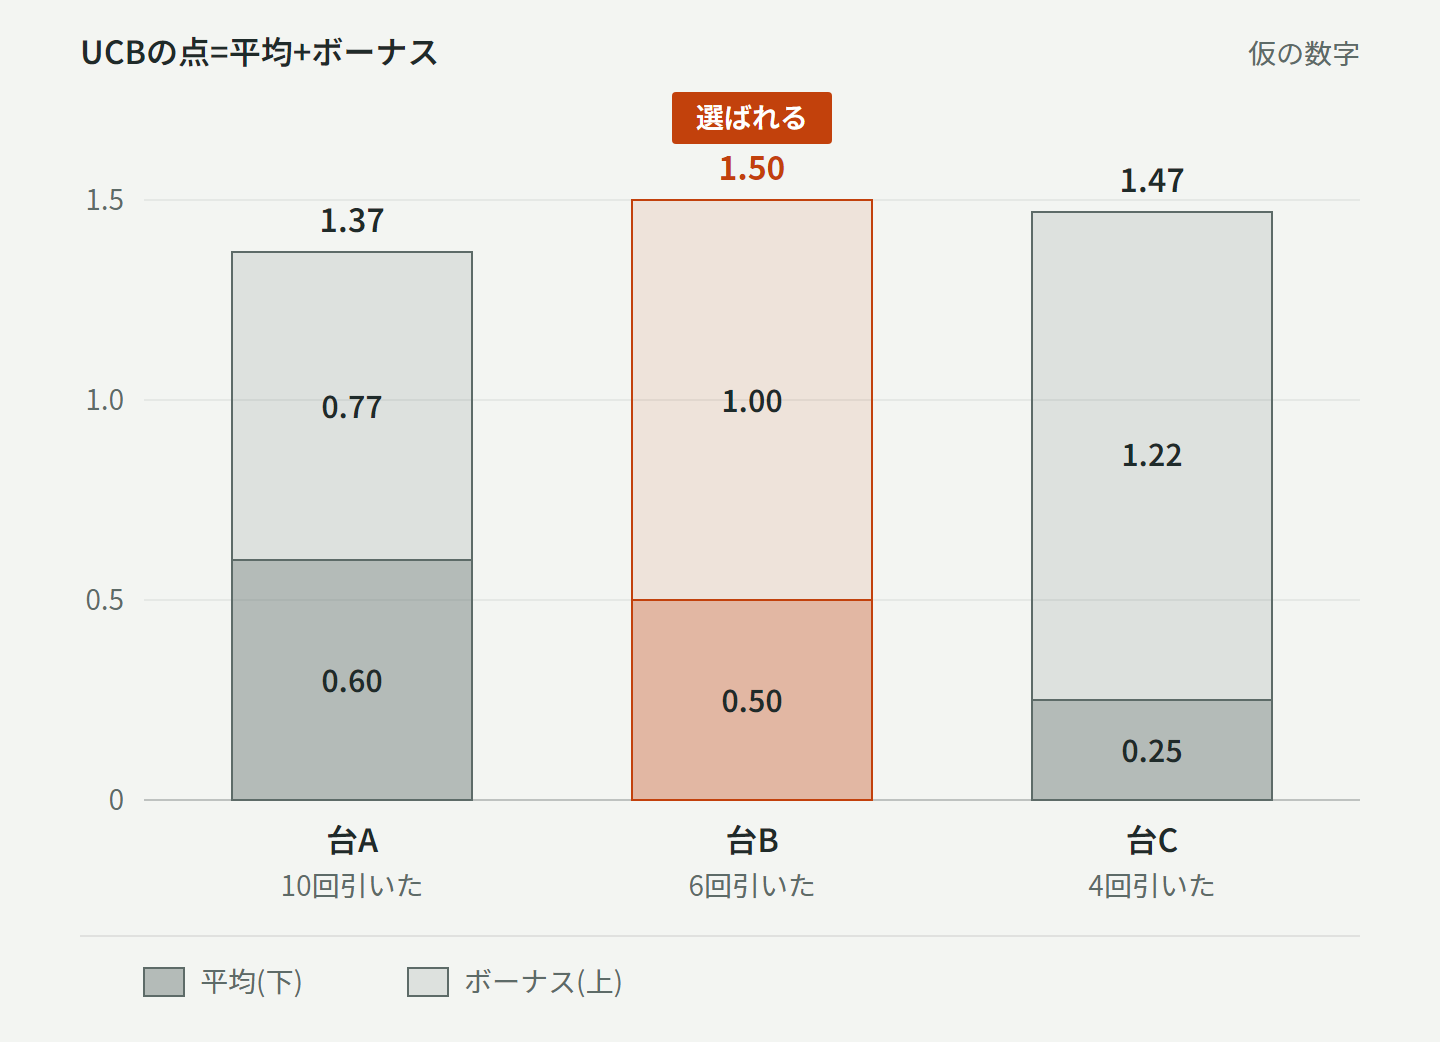
| 台 | 引いた回数N | 当たり | 平均 | ボーナス √(2 ln 20 ÷ N) | UCBの点 |
|---|---|---|---|---|---|
| A | 10 | 6 | 0.60 | 0.77 | 1.37 |
| B | 6 | 3 | 0.50 | 1.00 | 1.50 |
| C | 4 | 1 | 0.25 | 1.22 | 1.47 |
台Aのボーナスを手で計算してみます。ln 20は約3.00で、2 ln 20は約5.99です。これをN=10で割ると約0.599になり、そのルートが約0.77です。平均の0.60に足すと、UCBの点は1.37になります。
UCBの点がいちばん高いのは、1.50の台Bです。
平均だけで選ぶなら台Aで、回数がいちばん少ない台を選ぶなら台Cです。UCB方策が選ぶのはそのどちらでもありません。足し算の結果として、台Bを選びます。台Cとの差は0.03しかないので、小数第2位まで見ないと順番が分かりません。
この回数では、3台ともボーナスのほうが平均より大きい状態です。最初のうちは、回数の少ない台のボーナスが点数を大きく押し上げます。台Bを引けばNが増えて、台Bのボーナスは1.00より小さくなります。
ε-greedyとの違いと、後悔の増え方
ε-greedyとは
ε-greedy(イプシロン・グリーディ)は、探索の方法としてUCBと並べてよく説明される方法です。動きは2通りです。確率1−εで、今いちばん良さそうな選択肢を選びます。確率εで、全部の選択肢から一様にランダムに選びます。
εの値の例としてよく挙げられるのは0.1です。ε=0.1なら、10回に1回くらいはランダムに選ぶということです。
このランダムは、いつもの選択肢も含みます。「ときどき別の選択肢を選ぶ」という言い方だと、定義より狭くなります。ε=0.1のとき、いつもの選択肢を選ぶ確率は0.9+0.1×(1/選択肢数)です。台が3台なら、0.9+0.1×(1/3)で約0.933になります。
ε-greedyの考え方は、こちらの記事で解説しています。
比較表
表の「線形」は回数に比例して増えること、「対数」は増え方がだんだん緩やかになることです。
| 項目 | UCB方策 | ε-greedy |
|---|---|---|
| 探索の仕方 | 回数が少ない選択肢ほどボーナスを足して選ぶ | 確率εで全部の選択肢から一様にランダムに選ぶ |
| 活用の仕方 | 平均+ボーナスが最大のものを選ぶ | 確率1−εで平均が最大のものを選ぶ |
| 探索に使う情報 | 選択肢ごとの回数と全体の回数 | ランダムに選ぶときは過去の結果を使わない |
| 決める値 | c(UCB1ではc=√2) | ε(0.1がよく挙げられる) |
| 後悔(理論) | UCB1は、後悔の上限が回数の対数で増えることが、Auerらの2002年の論文(Theorem 1)に示されている | εを一定にすると、後悔は対数でなく線形に増えると同じ論文にある。εを回数nに応じて小さくする版(εn-greedy。Theorem 3)は、調整すれば対数の上限が示される |
| 実装 | 回数の記録とボーナスの計算を書く | 乱数で2通りに分けて書く |
UCB1の後悔の上限は、記号で書くとO(log n)(nは引いた回数)になります。
いちばん大きな違いは、探索の先の決め方です。UCB方策は、回数の少ない選択肢を優先して探索します。ε-greedyのランダムな探索では、十分に試した選択肢や、良くないと分かってきた選択肢を引くこともあります。その代わり、ε-greedyのコードは乱数で分けるだけの短い形です。
UCB方策のメリットは、どの選択肢を探索するかを回数で決められることです。UCB1ならc=√2で書けるので、自分で決める値も減ります。デメリットは、後の「注意点」にまとめました。
どちらが良いかは問題によります。同じ論文の実験では、うまく調整したεn-greedyがほとんどの場合で最良だったとあります("An optimally tuned εn-GREEDY performs almost always best.")。調整が合っていないと性能が急に落ちる、という趣旨の記述もあります。
後悔の増え方を数字で見る
比較の話では、「後悔(Regret)」という言葉もよく出てきます。後悔は、最初から最良の選択肢を選び続けた場合の報酬の合計と、実際に得た報酬の合計との差です。この差が小さいほど、損の少ない選び方だったことになります。
次の表の値は、最良の台との当たり確率の差を、引くたびに足したものです。実際に当たった数の差ではなく、確率の差(期待値)で見ている点が、上の定義と違います。当たり確率0.1〜0.5の5台で、UCB1と、εを固定したε-greedyを、それぞれ200回繰り返した平均です。
| 回数 | UCB1 | ε=0.1 | ε=0.01 |
|---|---|---|---|
| 100 | 14.7 | 9.7 | 10.8 |
| 1000 | 81.3 | 48.3 | 75.9 |
| 10000 | 230.5 | 247.5 | 331.6 |
| 100000 | 392.4 | 2047.4 | 738.0 |
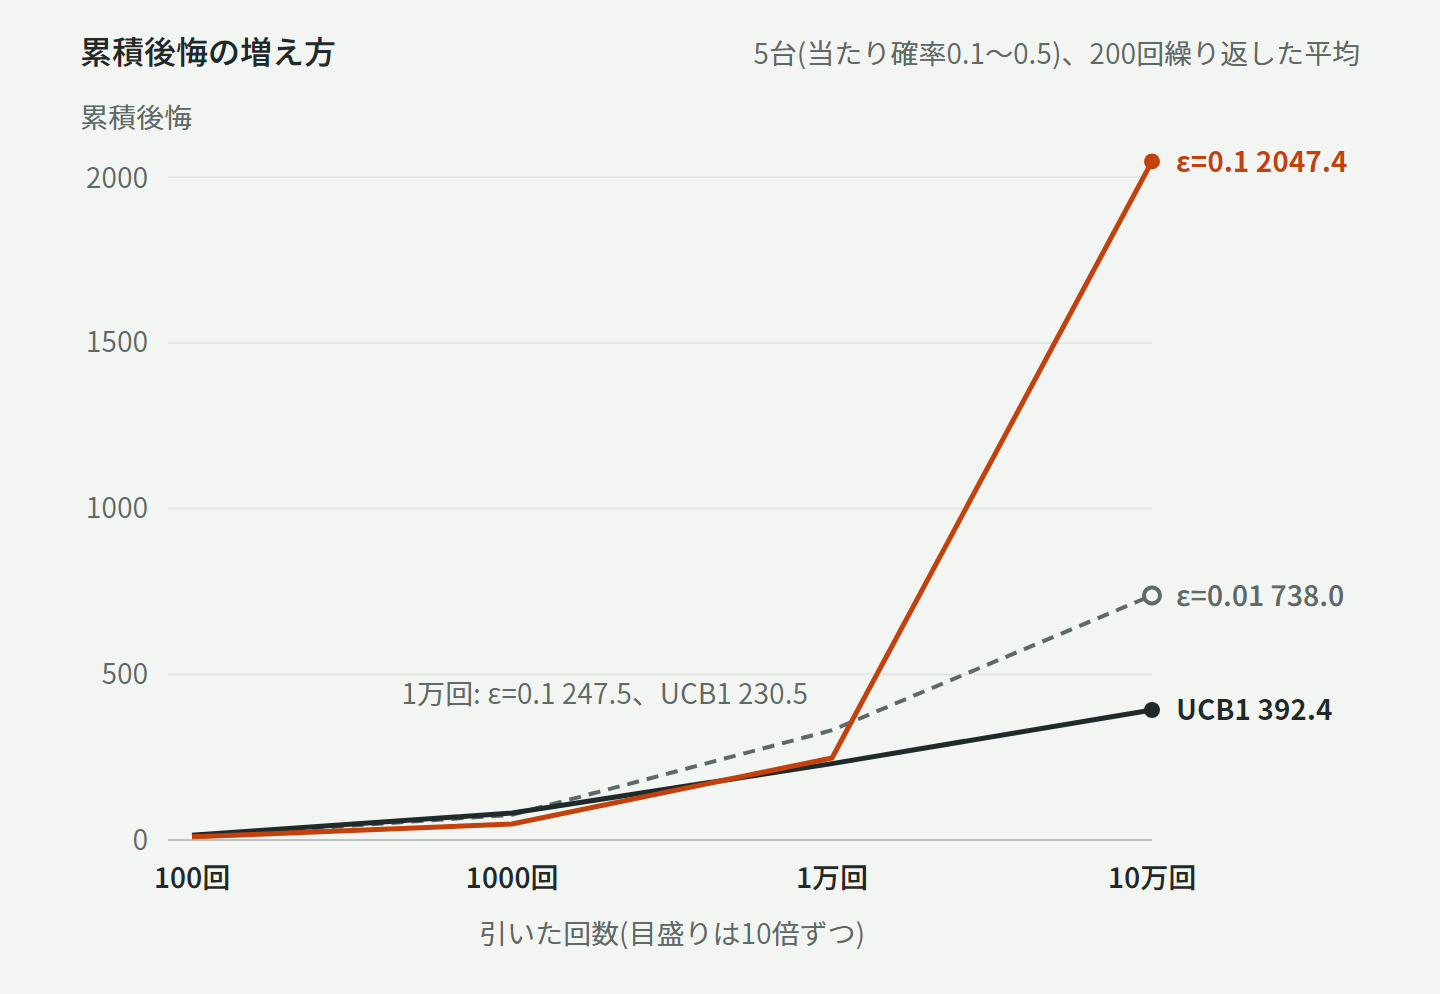
1000回までは、ε=0.1のほうが後悔は少なめです(100回で9.7、1000回で48.3。UCB1は14.7と81.3)。1万回の時点では逆転していて、ε=0.1が247.5、UCB1が230.5でした。10万回では、ε=0.1が2047.4、UCB1が392.4、ε=0.01が738.0です。
回数が10倍になるごとの倍率は、次のとおりです。UCB1は5.52倍、2.84倍、1.7倍と小さくなり、ε=0.1は4.96倍、5.13倍、8.27倍と大きくなります。線形に増えるなら10倍ごとに10倍なので、ε=0.1はそこへ近づいています。ε=0.01は7.04倍、4.37倍、2.23倍で、10万回までの範囲では線形の増え方はまだ見えません。
この表は、固定のεと、この5台の確率での結果です。UCB1の後悔がいつも少ないという意味ではありません。
注意点
UCB方策を使うときに気にしたい点は3つあります。
1つ目は、報酬の範囲です。ここで使っている式は、報酬が0〜1に収まることを前提にしています。範囲の違う報酬をそのまま入れると、平均とボーナスの大きさの釣り合いが変わります。
2つ目は、最初にかかる回数です。全部の選択肢を1回ずつ試すので、選択肢が多いと、それだけで多くの回数を使います。
3つ目は、報酬の確率が時間で変わる場合です。標準のUCBは、各台の当たり確率が変わらないことを想定しています。利用者の好みが変わるような場面では、古い結果をもとに選び続けて、合わなくなることがあります。
使われる場面の例と発展形
「結果が分からない選択肢から繰り返し選び、報酬の合計を増やしたい」という形の問題は、多腕バンディット問題の仲間です。当てはめられる問題の例として、Web最適化、推薦、広告の3つを挙げます。
Web最適化(A/Bテスト)では、台がデザイン案、当たりがクリックや購入です。案ごとに均等に割り振るA/Bテストと違い、結果を見ながら割り振りを変える形になります。推薦では、台が商品や記事、当たりが利用者の反応です。広告でも、台を広告、当たりをクリックと置けます。
発展形の例は、報酬のばらつきもボーナスに反映するUCB1-Tuned、利用者や商品の特徴を数値にして状況ごとに選ぶLinUCB、過去の情報を少しずつ割り引くDiscounted UCBです。近い目的の方法として、トンプソンサンプリングもあります。
確認問題2問(自作)とまとめ
確認問題(自作)
ここの2問は、この記事のために作った確認問題です。実際の試験とは形式も難しさも違うことがあります。
問1(概念) UCB方策の根底にある考え方として、最も適切なものはどれか。
- ア 過去の平均だけを信じて、いちばん平均が高い選択肢を選び続ける
- イ 試した回数が少なく不確かな選択肢ほど、良い可能性を高めに見積もる
- ウ 一定の確率で、全部の選択肢から一様にランダムに選ぶ
- エ すべての選択肢を、同じ回数ずつ選ぶ
タップして正解を表示
答えはイです。UCB方策の考え方は、一般に「不確かさに対する楽観主義」と呼ばれます。アは活用だけの選び方で、ウはε-greedyの探索のしかたです。エは、UCB方策にもε-greedyにも当てはまりません。
問2(挙動) UCB方策で、ある選択肢を連続して選び続けたとき、その選択肢のボーナス項はどう変化するか。
- ア 増え続ける
- イ 小さくなっていく
- ウ 変わらない
- エ 一度大きくなってから小さくなる
タップして正解を表示
答えはイです。続けて選ぶと全体の回数tも増えますが、その台の回数Nが増えて割る数が大きくなるので、ボーナスは小さくなります。t=100、N=10の台を続けて選ぶと、次のように変わります(c=√2)。
| 続けて選んだ回数 | N | t | ボーナス |
|---|---|---|---|
| 0 | 10 | 100 | 0.96 |
| 1 | 11 | 101 | 0.916 |
| 10 | 20 | 110 | 0.686 |
| 100 | 110 | 200 | 0.31 |
| 1000 | 1010 | 1100 | 0.118 |
まとめと次の一歩
要点は次の4つです。
- UCB方策は、「平均+ボーナス」が最大の選択肢を選びます。
- ボーナスは回数が少ないほど大きく、信頼区間の上側の値で比べます。
- ln tを使うと、選ばれない台のボーナスは緩やかに増えます。
- ε-greedyと比べて後悔がどう増えるかは、回数や条件で変わります。
ε-greedyと見比べるなら、ε-greedyの記事が次の一歩になります。
ここまでのスロットは、1回ごとに終わる選択の話でした。迷路のように選択がつながる問題に進むと、「その先まで合わせた点の見込み」を表すQ値が出てきます。Q値は、Q値の記事で解説しています。
コードで確かめたい人向けの節は、このすぐあとの【補足】です。
【補足】Pythonで挙動を確かめたい人向け
Pythonが読めなくても、ここまでの内容は分かるように書きました。
私はPythonでデータ分析の連載を書きました。
ここでは、UCB1の流れを1本のコードにして載せます。標準ライブラリだけで動くので、写してそのまま実行できます。
UCB1の1ステップ
UCB1の流れを図にしたものが、次の図です。
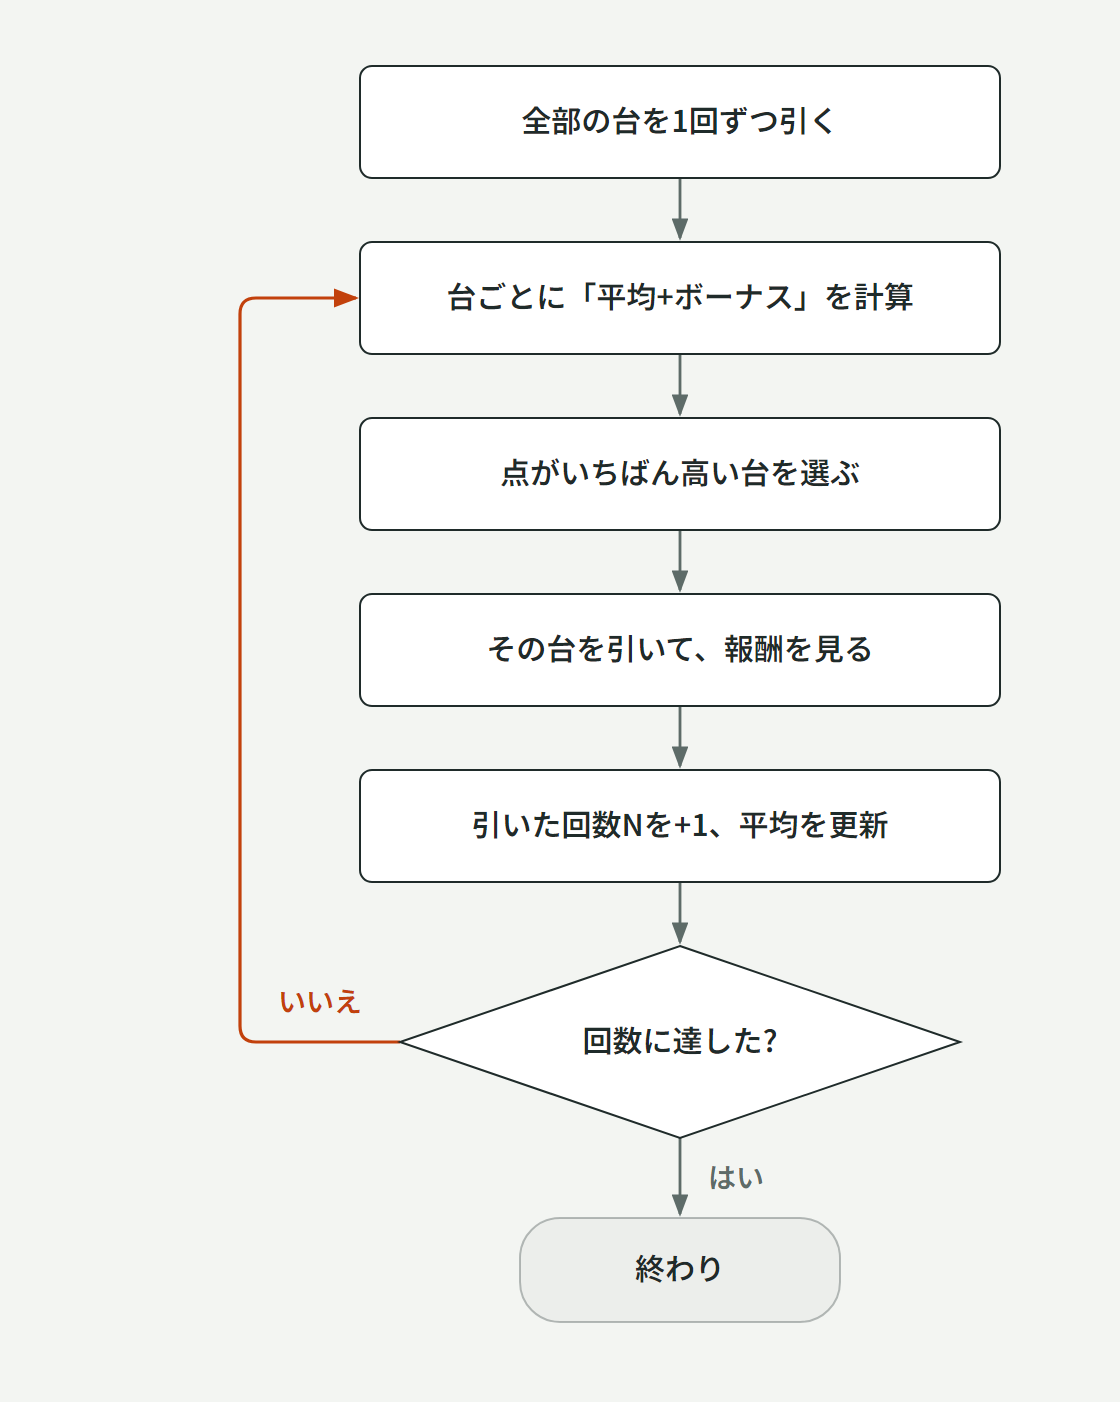
回数Nを1にして、平均をそのときの報酬にします。UCB1の典型的な手順の一つです。N=0のままだと、ボーナスの式で割り算ができません
台ごとに「平均+ボーナス」を計算します
その台を引いて、当たりかはずれかを見ます
引いた台のNを1増やし、平均を直します。決めた回数に達するまで、点の計算に戻ります
コード
import math
import random


def ucb1(K, c, play_arm, max_steps):
    """UCB1で多腕バンディット問題を解く。報酬は0〜1を前提とする。"""
    N = [0] * K      # 各台を引いた回数
    Q = [0.0] * K    # 各台の平均報酬
    total_reward = 0
    selected = []

    # 初期化: 全部の台を1回ずつ引く
    for a in range(K):
        r = play_arm(a)
        N[a] = 1
        Q[a] = r
        total_reward += r
        selected.append(a)

    # メインループ: t はこれまでに引いた回数の合計
    for t in range(K, max_steps):
        ucb = [Q[a] + c * math.sqrt(math.log(t) / N[a]) for a in range(K)]
        a = ucb.index(max(ucb))
        r = play_arm(a)
        total_reward += r
        selected.append(a)
        N[a] += 1
        Q[a] += (r - Q[a]) / N[a]   # 平均の増分更新(N は更新後の回数)

    return total_reward, selected


if __name__ == "__main__":
    p = [0.1, 0.2, 0.3, 0.4, 0.5]   # 台ごとの当たり確率(本当は知らない)
    rng = random.Random(0)
    play = lambda a: 1 if rng.random() < p[a] else 0
    total, arms = ucb1(len(p), math.sqrt(2), play, 1000)
    print("合計:", total)
    print("各台を引いた回数:", [arms.count(a) for a in range(len(p))])
コードの読み方
コードのQが、ここまでの平均です。読むところは、初期化、選ぶ、更新の3か所に絞ります。
初期化は、最初のforループです。5台を順に1回ずつ引き、N[a]を1に、Q[a]をその報酬にします。全部の台のNが1になるので、後の割り算でNが0になることはありません。
選ぶところは、次のforループの先頭の2行です。tは、これまでに引いた回数の合計で、t=5から始まります。c * math.sqrt(math.log(t) / N[a])の部分がボーナスです。ucb.index(max(ucb))で、点がいちばん高い台の番号を取り出します。
更新は、ループの最後の2行です。順番が大事で、N[a] += 1で回数を先に増やし、そのあとに新しい回数で割って平均を直します。
新しい平均は「古い平均 + (報酬 − 古い平均) ÷ 更新後の回数」です。数値例の台Bで考えます。平均0.50で6回引いた台Bが7回目に当たると、0.50 + (1 − 0.50) ÷ 7で約0.57になります。当たりの合計を回数で割った4 ÷ 7と同じ値です。
報酬を出すのはplayの行です。当たり確率p[a]で1を、それ以外で0を返します。pは動きを見るために置いた値で、ucb1の中では見ていません。
動かしたときに見るところ
実行すると、合計は409と出ます。各台を引いた回数は、次のとおりです。乱数のseedを0に固定しているので、実行するたびに数字が変わることはありません。
| 当たり確率 | 0.1 | 0.2 | 0.3 | 0.4 | 0.5 |
|---|---|---|---|---|---|
| 引いた回数 | 33 | 74 | 112 | 321 | 460 |
見るところは2つあります。
1つ目は、最初の5回です。armsの先頭5個を表示すると[0, 1, 2, 3, 4]で、各台を1回ずつ引いたことが分かります。
2つ目は、回数の偏りです。当たり確率0.5の台がいちばん多く、確率が下がるほど回数も減っています。一方で、当たり確率0.1の台を引いた回数も33回です。平均が低くても、回数が少ないままだとボーナスが大きくなるので、ときどき順番が回ってきます。
seedを0〜19の20通りに変えて1000回ずつ動かすと、当たり確率0.5の台が最も多く引かれたのは20通りすべてでした。これはこの条件での結果で、確率の差や回数を変えれば結果も変わることがあります。
ここでmath.log(t)をtに替え、seedを0〜199の200通りに変えて1000回ずつの平均をとると、「なぜln tなのか」の節の表のtの行になります。この節の409はseedが0の1通りの結果で、表の419.0は200通りの平均です。
この記事とあわせて読まれている記事です。

コメント